De OpenSearch para Typesense: reduzindo custos sem abrir mão de uma busca inteligente
Migramos a busca da Space4.me de OpenSearch para Typesense para reduzir custos e adequar a infraestrutura ao estágio atual do produto. No processo, redesenhamos a indexação de disponibilidade com uma janela móvel de 90 dias, criamos uma camada unificada para agendas internas e externas e adotamos sincronização incremental por espaço. O resultado foi uma arquitetura mais simples, eficiente e econômica, mantendo a busca rápida e preparada para crescer.
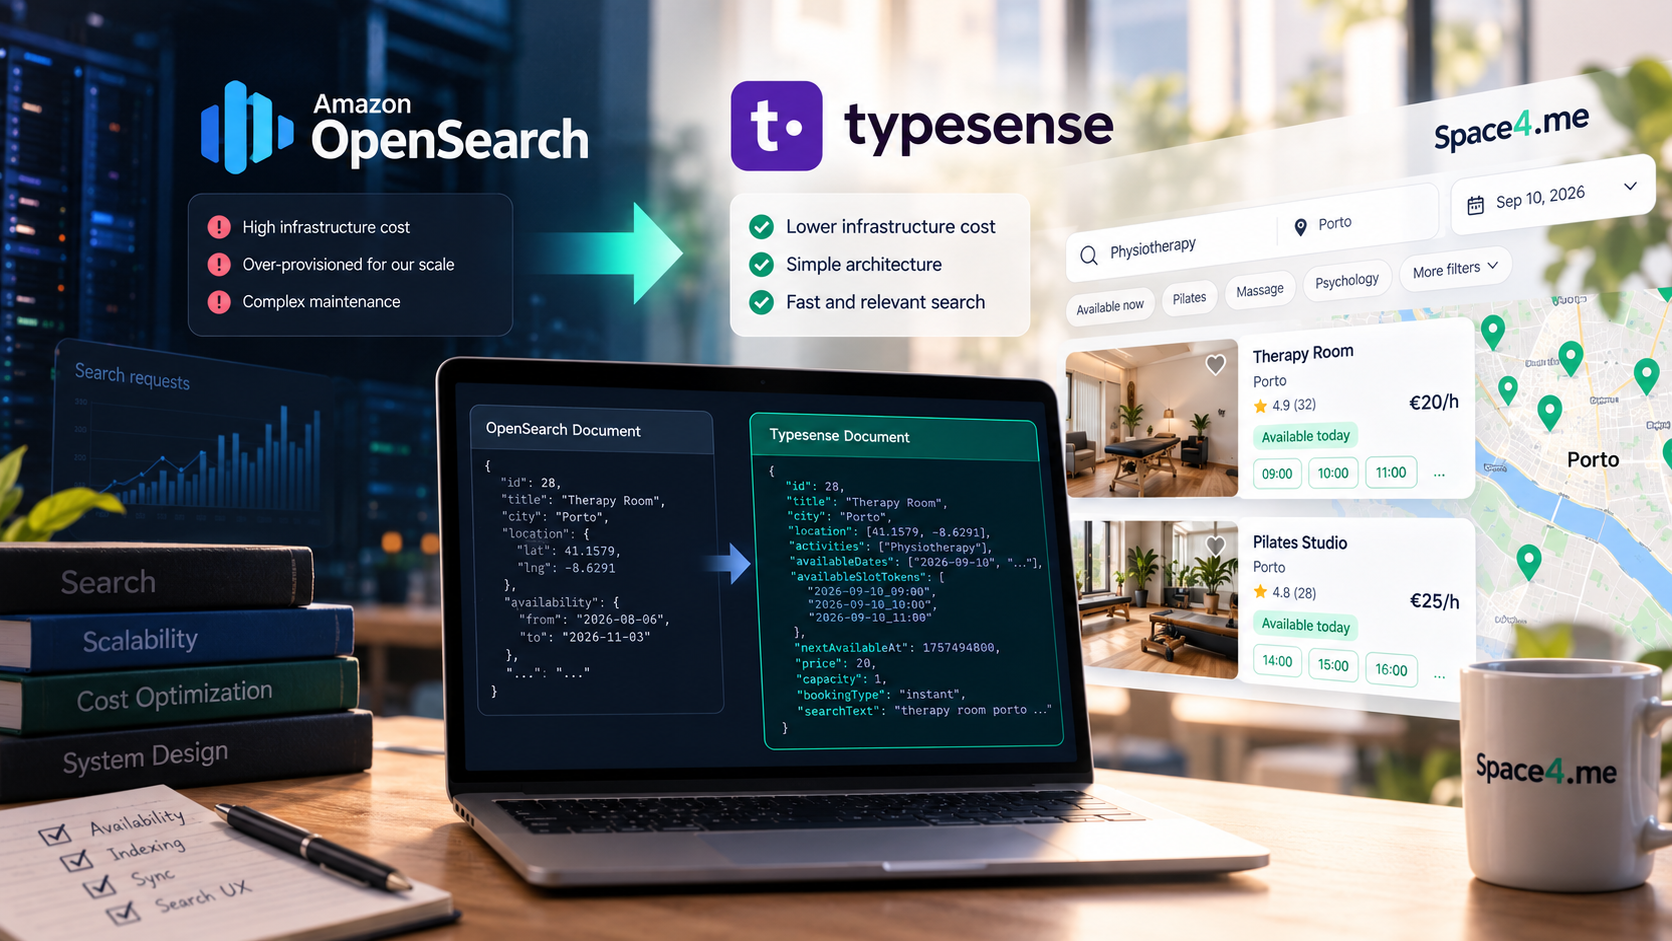
Quando começamos a desenvolver a busca da Space4.me, escolhemos o Amazon OpenSearch como motor de pesquisa. Tecnicamente, fazia sentido: precisávamos pesquisar espaços considerando localização, atividades, características do espaço e, principalmente, disponibilidade.
O problema não estava na capacidade do OpenSearch.
Estava na relação entre essa capacidade e o momento do produto.
Ainda estávamos numa fase inicial, com um volume relativamente pequeno de espaços e pesquisas, enquanto mantínhamos uma infraestrutura de busca dimensionada para cenários muito maiores.
Isso nos levou a uma pergunta simples:
Precisamos realmente dessa infraestrutura agora?
Foi a partir daí que começamos a avaliar o Typesense.
O problema não era apenas trocar o motor de busca
À primeira vista, migrar de OpenSearch para Typesense poderia parecer simplesmente uma questão de exportar documentos de um índice e importá-los em outro.
Mas nossa busca tinha uma particularidade importante: disponibilidade.
Na Space4.me, encontrar um espaço não significa apenas descobrir um gabinete de fisioterapia no Porto, por exemplo.
O espaço precisa estar disponível no dia e horário que o profissional procura.
E disponibilidade é um dado extremamente dinâmico.
Um espaço pode estar disponível às 14:00 e, segundos depois, receber uma reserva. Além disso, diferentes espaços podem ter regras e até fontes de agenda diferentes.
Por isso, antes de migrarmos o mecanismo de busca, tivemos que repensar como representar disponibilidade dentro do índice.
Indexar horários sem transformar o índice numa agenda
Uma das primeiras decisões foi não tentar transformar o Typesense na fonte oficial da disponibilidade.
Essa responsabilidade continua pertencendo ao nosso sistema de reservas e aos provedores de agenda integrados.
O índice funciona como uma representação otimizada para pesquisa.
Para isso, passamos a gerar documentos contendo informações como:
availableDates
availableSlotTokens
nextAvailableAt
atividades disponíveis
cidade e localização geográfica
preço
capacidade
tipo de reserva
características do espaço
Um availableSlotToken, por exemplo, pode representar um horário desta forma:
2026-09-10_14:00
Assim, em vez de calcular toda a disponibilidade durante cada pesquisa, conseguimos responder rapidamente a perguntas como:
Quais espaços de fisioterapia no Porto estão disponíveis no dia 10 às 14:00?
Grande parte desse trabalho passa a ser realizada diretamente pelo índice.
Uma janela móvel de disponibilidade
Outro problema apareceu rapidamente.
Não fazia sentido indexar indefinidamente todos os horários futuros de todos os espaços.
Quanto maior fosse o período indexado, maior seria o número de tokens armazenados e maior seria o custo de manter esses dados atualizados.
Optamos então por trabalhar com uma janela móvel de 90 dias.
O sistema calcula a disponibilidade futura dentro dessa janela e mantém no Typesense somente os dados relevantes para pesquisa.
Também utilizamos campos como availableDates e nextAvailableAt para permitir filtros e ordenações sem precisar consultar todo o sistema de agenda.
Essa abordagem trouxe um equilíbrio importante:
informação suficiente para uma busca rápida, sem transformar o índice em uma cópia completa do sistema de reservas.
O desafio das diferentes fontes de agenda
A arquitetura ficou ainda mais interessante porque nem toda disponibilidade necessariamente nasce dentro da Space4.me.
Um espaço pode utilizar nossa agenda interna ou ter sua disponibilidade originada de um sistema externo.
Se cada integração tivesse sua própria lógica de indexação, rapidamente teríamos um problema de manutenção.
Por isso criamos uma camada de disponibilidade unificada.
Antes de enviar qualquer espaço para o Typesense, nosso processo consulta essa camada, que sabe como obter a disponibilidade independentemente da origem.
O fluxo conceitualmente passou a ser:
Fonte da agenda ↓ Disponibilidade unificada ↓ Transformer ↓ Typesense
Para o mecanismo de busca, não importa mais se determinado horário veio da nossa base de dados ou de um provider externo.
Ele recebe sempre a mesma representação.
Essa separação acabou sendo uma das partes mais importantes da arquitetura.
Sincronização incremental
Outro cuidado importante foi evitar a reconstrução completa do índice sempre que alguma coisa mudasse.
Criamos dois mecanismos diferentes de sincronização.
Um processo completo consegue reconstruir o índice quando necessário, percorrendo todos os espaços publicados e recalculando seus documentos.
Mas, na operação normal, utilizamos uma estratégia incremental.
Quando alguma informação relevante de um espaço muda, podemos sincronizar apenas aquele espaço.
O processo é aproximadamente:
Space ID ↓ Dados do espaço ↓ Disponibilidade ↓ Transformação ↓ Upsert no Typesense
Isso significa que uma alteração em um espaço não exige reindexar todos os outros.
Essa estratégia tornou a sincronização mais barata, rápida e previsível.
Também nos deu uma ferramenta importante para operação: se identificamos algum problema em um espaço específico, podemos reconstruir somente aquele documento.
O índice não é a fonte da verdade
Essa talvez seja uma das decisões arquiteturais mais importantes do projeto.
O Typesense responde:
“Quais espaços provavelmente atendem aos critérios desta pesquisa?”
Mas o sistema de reservas continua responsável por responder:
“Este horário continua realmente disponível neste momento?”
Essa distinção é fundamental.
Disponibilidade indexada pode ficar temporariamente desatualizada entre uma alteração e sua sincronização.
Por isso, usamos o índice para reduzir drasticamente o universo da pesquisa, mas mantemos a validação final da disponibilidade no fluxo de reserva.
Isso nos permite aproveitar a velocidade de um search engine sem delegar a ele uma responsabilidade transacional.
Um documento preparado para a busca
Durante a migração também percebemos que não deveríamos simplesmente reproduzir no Typesense a estrutura das tabelas da aplicação.
Banco de dados e índice de pesquisa possuem objetivos diferentes.
Criamos então um transformer responsável por converter um espaço no documento ideal para pesquisa.
Esse documento reúne informações que originalmente podem estar distribuídas por diferentes entidades do sistema.
Em vez de obrigar a busca a reconstruir essas relações a cada requisição, fazemos parte desse trabalho durante a indexação.
É uma troca intencional:
mais processamento durante a sincronização para obter muito menos processamento durante a pesquisa.
E o custo?
A motivação inicial do projeto era financeira.
O OpenSearch é uma solução extremamente poderosa, mas estávamos pagando pela disponibilidade de uma infraestrutura que nosso volume naquele momento simplesmente não justificava.
Nosso cenário era de alguns milhares de espaços — e não milhões de documentos ou centenas de milhares de pesquisas por segundo.
Ao migrarmos para uma instância muito mais simples executando Typesense, conseguimos reduzir significativamente o custo fixo associado à infraestrutura de pesquisa.
Mais importante que a economia absoluta foi melhorar a relação entre:
custo → volume → necessidade real do produto.
Em uma startup, otimização de infraestrutura não significa necessariamente encontrar a tecnologia mais poderosa.
Significa encontrar a tecnologia adequada para o problema e para o estágio atual do negócio.
A arquitetura ficou mais simples
Curiosamente, começamos esse projeto pensando principalmente em custo e terminamos com ganhos arquiteturais.
A migração nos obrigou a definir melhor:
quem é responsável pela disponibilidade;
como diferentes agendas são normalizadas;
como horários são representados para pesquisa;
quando um documento deve ser atualizado;
como reconstruir um único espaço;
como reconstruir todo o índice;
e qual sistema é realmente a fonte da verdade.
O resultado foi uma arquitetura aproximadamente assim:
Agendas internas/externas ↓ Camada unificada de disponibilidade ↓ Transformer ↓ Documento de busca ↓ Typesense ↓ API de Search
E, no momento da reserva:
Resultado da busca ↓ Validação de disponibilidade ↓ Reserva
Essa separação tornou cada componente muito mais claro.
O que aprendemos
Talvez o principal aprendizado dessa migração seja que arquitetura precisa acompanhar o estágio do produto.
OpenSearch não era uma escolha errada.
Typesense também não é simplesmente uma escolha “melhor”.
São ferramentas diferentes para necessidades diferentes.
No nosso momento atual, simplicidade operacional, velocidade de busca e baixo custo possuem um peso muito maior do que recursos avançados que ainda não utilizamos.
Também aprendemos que otimizar busca não significa apenas escolher um search engine rápido.
Grande parte do desempenho vem de modelar corretamente o dado antes que a pesquisa aconteça.
Representar disponibilidade através de datas e slots previamente calculados, trabalhar com uma janela móvel, normalizar diferentes fontes de agenda e realizar sincronizações incrementais permitiu que a busca ficasse simples justamente porque boa parte da complexidade foi resolvida antes.
No final, a migração de OpenSearch para Typesense começou como um projeto para reduzir custos.
Mas acabou se tornando também um exercício de simplificação arquitetural.
E talvez essa seja uma das melhores otimizações que podemos fazer em um produto que ainda está crescendo:
não construir para a escala que imaginamos ter um dia, mas criar uma arquitetura simples o suficiente para funcionar bem hoje e preparada o suficiente para evoluir amanhã.
Artigos relacionados
Construir o futuro sem parar a plataforma
Como evoluir radicalmente um produto sem descuidar da plataforma de que os clientes já dependem? Lições da evolução do MensagemHub para o BLiP na Take Blip.
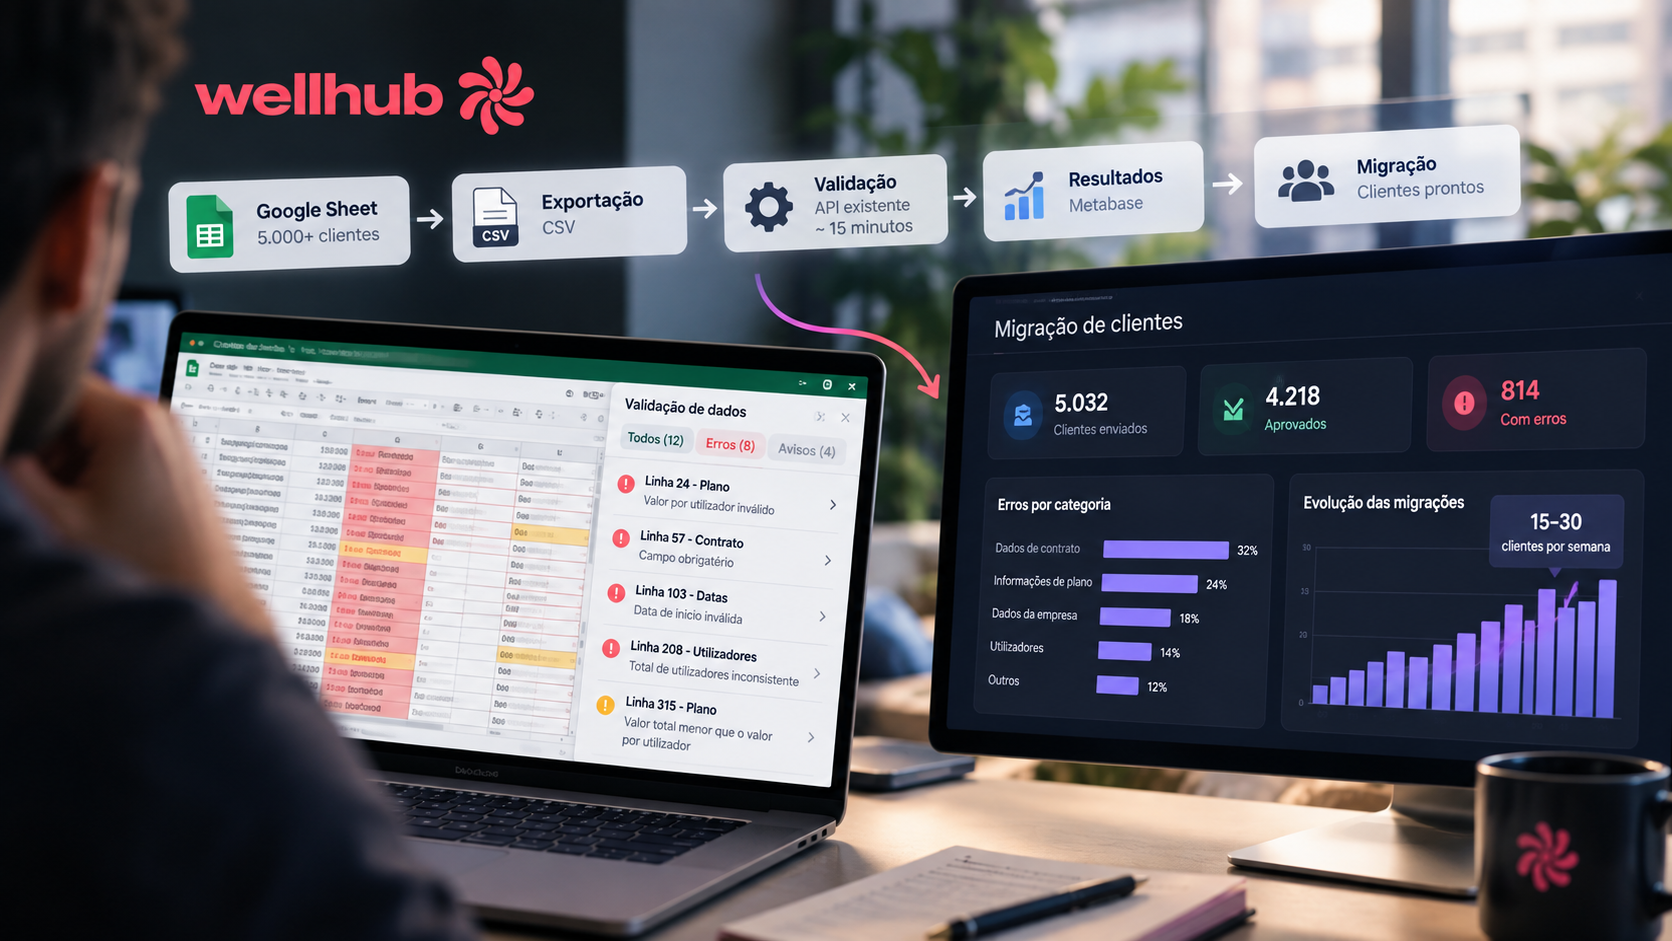
Como redesenhamos um processo de migração de 5.000+ clientes na Wellhub
Como redesenhamos um processo de migração de mais de 5.000 clientes na Wellhub, aumentando o ritmo de 10–15 migrações por mês para 15–30 por semana. O principal ganho não veio de tornar a API mais rápida, mas de melhorar validações, feedback de erros, observabilidade e autonomia operacional.